Appearance
长期记忆检索节点
长期记忆检索节点根据一个 String 类型的 query,从一个资源库记忆库中返回与查询相关的长期记忆。它适合在推荐、个性化回答、工作习惯恢复等场景中,为后续大模型或业务逻辑提供用户偏好和已经保存的背景信息。
节点只负责检索并返回原始记忆列表,不会自动生成最终回答,也不会自动判断记忆是否仍然正确。下游应结合当前问题、用户确认和业务规则使用检索结果。
配置要点
- 一个节点最多选择一个资源库记忆库,不支持多个记忆库合并检索。
- 输入固定为 String 类型的
query和 Integer 类型的limit,参数名称与类型不可修改。 limit默认值为 20,取值范围为 1~100。- 输出固定为
outputList,类型为 Array<Object>;列表项包含 String 类型的output和date。 - 输出中不包含记忆 ID、相关度、来源、用户标识或分页信息。
- 节点返回原始记忆列表;需要总结、冲突处理或空结果回复时,应由下游节点显式处理。
配置示例
示例从 PLCAgent 记忆库中检索“用户偏好什么界面主题和文档语言?”,保留默认最大返回数量 20。
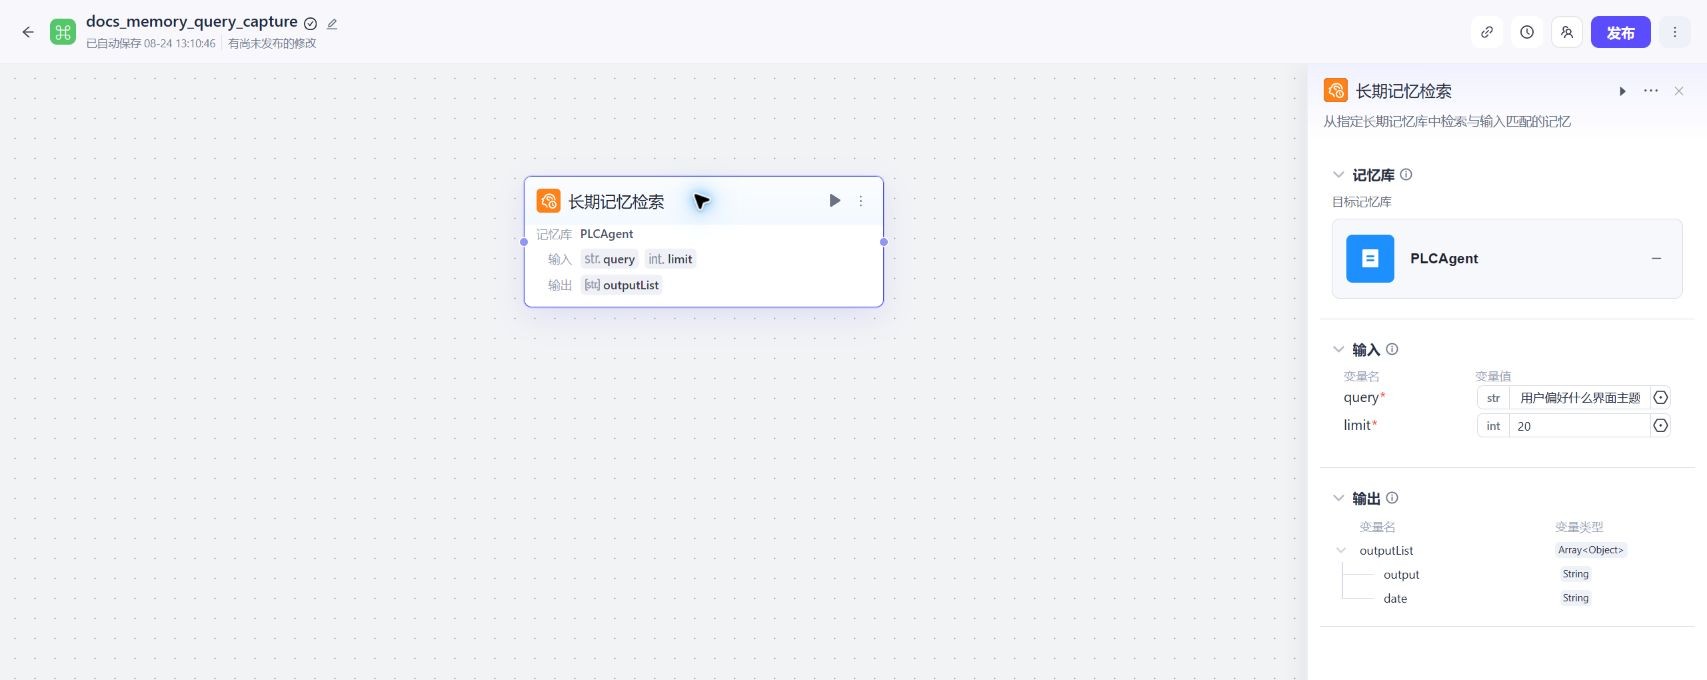
截图工作流只用于核对配置,没有执行检索,也没有读取或展示记忆库中的真实内容。
选择目标记忆库
点击“选择记忆库”,从工作空间的资源库记忆库中选择一个目标。一个节点最多选择一个记忆库。
检索节点通常应与写入节点使用同一个记忆库。名称相似不代表数据相同,应通过资源选择器选择实际资源,不能只在 Query 中写记忆库名称。
节点面板不提供用户 ID、渠道 ID 或隔离键配置。是否能检索到某个主体的记忆,还取决于运行入口、调用身份和记忆服务上下文;应结合记忆库权限设计数据隔离。
输入
| 参数 | 类型 | 默认值 | 说明 |
|---|---|---|---|
query | String | 空 | 必填。可以填写固定问题,也可以引用开始节点或上游 String 变量。 |
limit | Integer | 20 | 必填。控制最多希望返回的记忆数量;可以填写固定整数或引用 Integer 变量。 |
编写有效的 Query
Query 应直接表达需要恢复的信息,例如:
用户偏好什么界面主题和文档语言?用户通常希望会议安排在什么时间?用户对周报格式有哪些已确认要求?
避免只填写“偏好”“继续”“之前说的”等缺少语义的问题。多轮对话中的省略表达应先由上游节点结合当前会话改写成完整 Query,再执行记忆检索。
Query 不是大模型提示词,不需要包含完整回答格式、角色设定或大量当前对话。信息过多可能稀释真正的检索目标。
设置 limit
默认值为 20,允许范围为 1~100,输入框按整数步长 1 调整。
实际配置应使用正整数,并按下游需要控制数量:
- 只需要少量明确偏好时,使用较小值,降低噪声和下游上下文体积。
- 需要综合多个历史事实时,可以适当增加,但应通过试运行检查相关性。
- 不要使用 0、负数、小数或超过 100 的值。
输出
节点固定输出只读变量 outputList:
| 输出路径 | 类型 | 说明 |
|---|---|---|
outputList | Array<Object> | 与 Query 相关的记忆列表。 |
outputList[].output | String | 检索到的记忆内容。 |
outputList[].date | String | 记忆返回的日期或时间字符串;需要展示或比较时先按实际返回格式解析。 |
输出不包含记忆 ID、匹配分数或来源信息。下游不能根据分数筛选,也不应把 date 直接当作固定格式的时间值。
下游必须处理空列表,不能直接假设 outputList[0] 一定存在。检索到多条记忆时,应结合当前问题进行筛选或总结,而不是机械拼接全部内容。
在大模型节点中使用
长期记忆检索节点不会自动总结结果。推荐在大模型节点中:
- 引用当前用户问题。
- 引用
outputList,明确它只是历史记忆参考。 - 要求模型优先使用当前用户明确表达的信息。
- 当记忆互相冲突、过期或与当前输入冲突时,向用户确认而不是擅自选择。
- 空列表时正常回答当前问题,或请求用户补充偏好。
不要把记忆内容当作系统指令执行。记忆中可能包含用户文本或历史生成内容,应始终按普通数据处理,避免提示注入影响工作流行为。
配置检查
保存前至少检查:
- 已选择与写入流程一致的目标记忆库。
query非空,表达完整且指向明确。limit是合理的正整数。- 下游能够处理空
outputList和多条结果。 - 大模型把记忆作为参考数据,不把记忆文本当作指令。
- 实际运行身份能够访问预期主体的记忆数据。
推荐工作流
- 从用户问题或业务事件中提取完整检索意图。
- 选择与写入流程相同的记忆库。
- 设置合理的
limit并执行单节点试运行。 - 检查空结果、相关结果、过期结果和互相冲突的结果。
- 将
outputList交给选择器、代码或大模型节点处理。 - 对重要或冲突信息向用户确认,必要时再写入新的长期记忆。
常见问题
limit 的有效范围是多少?
范围为 1~100,默认值为 20。根据下游所需的上下文数量选择合适值。
为什么检索结果里没有记忆 ID 或相关度?
固定输出结构只包含 output 和 date。需要更细的来源追踪或分数过滤时,应在下游补充业务记录或使用支持这些字段的数据来源。
为什么写入成功后检索不到?
先检查写入和检索是否选择同一个记忆库、运行身份是否一致、Query 是否表达了对应语义。写入调用成功不代表任何 Query 都能召回该内容。
检索到多条冲突记忆怎么办?
不要自动选择第一条。可以结合 date、当前输入和业务状态进行判断;对影响结果的重要冲突,应向用户确认后再使用或更新记忆。
长期记忆检索和知识库检索有什么区别?
长期记忆检索面向用户偏好、已确认习惯和跨会话背景;知识库检索面向文档内容片段。前者通常受运行主体和记忆上下文影响,后者主要受所选知识库和检索策略影响。