Appearance
JSON 序列化节点
JSON 序列化节点用于把一个工作流变量编码成 JSON 格式的 String,便于传给只接收文本的 HTTP 接口、数据库字段、插件参数或消息节点。
“序列化”只负责编码当前输入值,不会解析字符串、校验业务字段、提取对象属性或修改原变量。已经是 JSON 字符串的数据通常不需要再次序列化;需要把 JSON 字符串恢复为对象或数组时,应使用 JSON 反序列化节点。
配置要点
| 项目 | 规则 |
|---|---|
| 输入 | 固定一个名为 input 的必填输入,可选择 String、Integer、Number、Boolean、Object 或 List。 |
| 输出 | 固定为 output,类型为 String;输出名称和类型不可编辑。 |
| 输出格式 | 生成紧凑 JSON,不提供格式化开关。 |
| 字符串输入 | 会按 JSON 字符串编码,自动增加双引号并转义特殊字符。 |
| 对象字段顺序 | 字段顺序不应作为业务契约。 |
适用场景
- 将大模型或代码节点输出的 Object 转成 HTTP 请求所需的 JSON 文本。
- 将对象或数组保存到数据库的 String/Text 字段。
- 把结构化参数传给只接受 String 的插件、消息或日志接口。
- 将列表转换为可持久化、可传输的紧凑 JSON 字符串。
以下情况不需要或不适合使用该节点:
- 输入本身已经是正确的 JSON String,且下游就是要接收这段 JSON:直接传递原字符串。
- 需要读取 JSON 字符串内部字段:使用 JSON 反序列化节点。
- 需要生成 URL 查询字符串、表单编码或 XML:使用 HTTP 请求节点的对应请求体,或使用专用转换节点。
- 需要调整字段、删除敏感项或重命名键:先用变量赋值、代码或其他结构化处理节点整理输入。
- 需要人类可读的缩进 JSON:节点没有格式化开关,可通过代码节点显式生成。
节点配置
JSON 序列化节点只有“输入”和“输出”两部分。
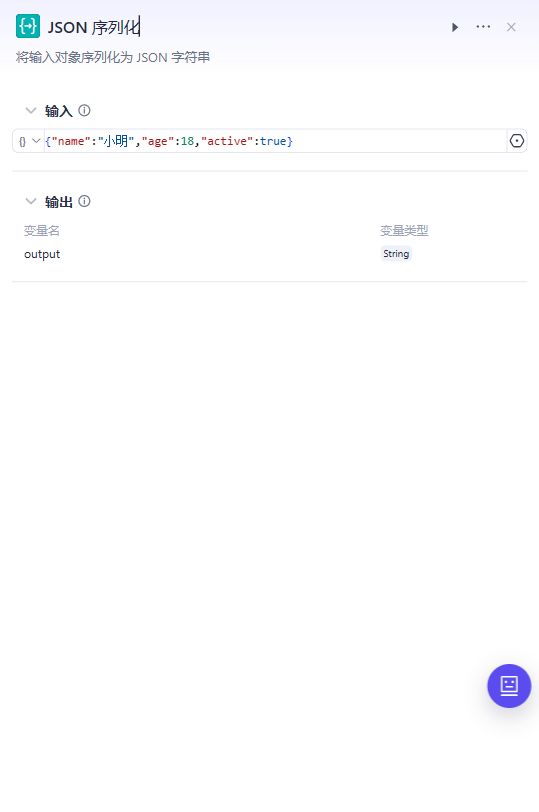
输入
| 配置 | 规则 |
|---|---|
| 变量名 | 固定为 input |
| 是否必填 | 必填;没有常量或有效的上游变量引用时不能通过发布校验 |
| 类型 | 可以在工作流变量类型中选择 |
| 值 | 可以填写常量,也可以引用上游节点输出 |
配置 Object 或 Array 常量时,编辑器中填写的内容必须能形成对应的合法 JSON 值。引用上游变量时,应选择与实际变量一致的类型,避免把结构化值误当作普通字符串处理。
输出
节点固定输出:
| 输出 | 类型 | 说明 |
|---|---|---|
output | String | 输入值序列化后的紧凑 JSON 字符串 |
输出结构不可添加字段,也不能把 output 改为 Object。若下游需要继续引用内部属性,不要在序列化后直接取 output.name;应继续使用原始对象,或先用 JSON 反序列化节点把字符串恢复为结构化值。
不同输入类型的结果
JSON 序列化遵循标准 JSON 值规则:
| 输入类型 | 输入示例 | output 的实际字符串内容 |
|---|---|---|
| String | 早上好 | "早上好" |
| Integer | 18 | 18 |
| Number | 3.14 | 3.14 |
| Boolean | true | true |
| Object | {"name":"小明","age":18} | {"name":"小明","age":18} |
| Array | ["A","B"] | ["A","B"] |
| 空值 | null | null |
表中右侧表示 output 字符串内部的内容。String 输入的 JSON 表示必须带双引号;换行、制表符、反斜杠和双引号等字符也会按 JSON 规则转义。
为什么试运行结果里出现反斜杠
下面的真实试运行将 Object 输入转换成了 String 输出:
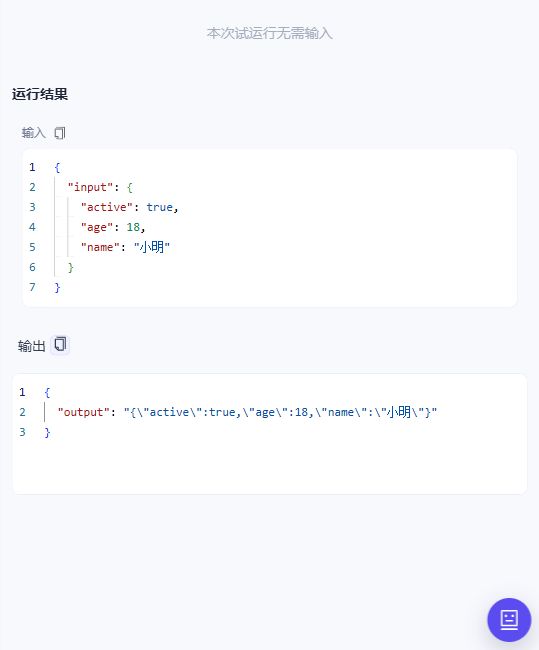
试运行面板展示的是包含 output 的外层结果对象。由于 output 本身是字符串,面板必须把字符串内部的双引号显示为 \":
json
{
  "output": "{\"active\":true,\"age\":18,\"name\":\"小明\"}"
}
下游节点引用 output 时,取得的是下面这段字符串内容,而不是带有外层键和显示转义的整段文本:
json
{"active":true,"age":18,"name":"小明"}不要手动删除试运行面板中的反斜杠,也不要复制整个外层结果作为 HTTP Body;直接引用节点的 output 变量。
与 HTTP 请求节点配合
“对象 → JSON 序列化 → HTTP 请求”是常见的数据转换流程:
- 上游节点生成 Object 或 Array。
- JSON 序列化节点引用该结构化变量。
- HTTP 请求节点选择 JSON 请求体,并在需要完整 JSON 文本的位置引用
output。
需要注意:HTTP 请求节点的 JSON 编辑器本身也要求最终请求体是合法 JSON。如果把整个 output 放在一对额外双引号中,它会变成“包含 JSON 的字符串”,而不是 JSON 对象。配置后应查看试运行的实际请求体,并以目标接口文档为准。
完整 HTTP 配置和请求体边界请参见 HTTP 请求节点。
与数据库节点配合
当数据库字段类型为 String、Text 或其他文本类型,而上游变量是 Object/Array 时,可以先序列化再写入。读取后如果还要按字段访问,则把取出的字符串交给 JSON 反序列化节点。
序列化不会自动创建数据库字段、修改字段类型或保证查询性能。需要按对象内部字段查询、排序或建立索引时,应考虑使用数据库原生 JSON 类型或拆分为独立字段,而不是长期把所有结构都存成普通字符串。
双重序列化
假设 String 输入本身为:
json
{"name":"小明"}再次执行 JSON 序列化后,output 的内容是一个 JSON 字符串值:
text
"{\"name\":\"小明\"}"这不是节点故障,而是对 String 再次编码的标准结果。判断是否需要本节点时,关键是确认上游值的变量类型:
- 上游是 Object/Array:通常需要序列化后交给 String 接口。
- 上游已经是 JSON String:通常直接传递。
- 上游是普通文本,但希望把它作为合法 JSON 字符串值:可以序列化。
数据一致性与安全
- JSON 对象的字段顺序不具备业务含义,不要通过字符串位置或字段排列判断结果。
- 序列化不会删除密码、Token、个人信息等敏感字段;进入日志、消息或外部接口前必须在上游脱敏。
- 紧凑 JSON 只减少空白,不代表数据量很小。大型数组和深层对象会增加传输、存储与后续解析成本。
- 节点不修改原输入,
output是新生成的 String。
发布前检查
input是否已经填写常量或引用有效的上游变量。- 所选输入类型是否与上游真实类型一致。
- 上游是否已经是 JSON String,是否存在不必要的二次序列化。
- Object/Array 常量是否为合法 JSON。
- 下游需要的是 JSON 对象文本、普通字符串,还是仍可访问字段的结构化变量。
- HTTP 请求体是否又给
output增加了一层引号。 - 是否错误依赖对象字段顺序。
- 输入中是否包含不应写入数据库、日志或外部服务的敏感字段。
- 试运行结果是否用真实边界样例覆盖了引号、换行、空值、数组和嵌套对象。
常见问题
为什么输入普通字符串后,输出多了一对双引号?
字符串的合法 JSON 表示本来就包含双引号。若下游只需要原始文本,不要使用 JSON 序列化节点,直接传递原 String。
为什么输出里有很多 \"?
试运行面板或日志经常把 output 放在外层 JSON 中展示,因此字符串内部的双引号需要转义。下游引用 output 变量时会得到实际字符串值,不需要手工移除反斜杠。
为什么对象字段顺序变了?
JSON 标准不保证对象字段顺序,编辑器、运行服务和下游解析器都可能重排键。业务逻辑应按字段名访问,不应比较原始字符串顺序。
为什么不能直接引用 output.name?
output 的类型固定为 String,内部字段不再是工作流可直接选择的结构。继续使用原对象,或在需要恢复结构时连接 JSON 反序列化节点。
为什么已经是 JSON 的字符串又被转义了一次?
节点根据变量类型处理:String 会作为字符串值再次编码。若上游已经输出 JSON String,请直接传递,不要重复序列化。
为什么没有缩进或格式化选项?
节点默认生成紧凑 JSON。需要面向人工阅读的缩进文本时,可以在代码节点中显式格式化,但接口传输和数据库存储通常优先使用紧凑格式。